
您针对`deepseek-chat`发布了原型,流量增长,现在账单、延迟尾流和偶尔的空JSON响应成为真实问题。本指南是我在从V3.2迁移到V4预览发布的那周后应用于自己V4部署的DeepSeek API最佳实践集。它假设您已有API密钥和可工作的OpenAI SDK调用,并专注于一旦超越“你好世界”,实际影响成本、可靠性和质量的选项。您将获得层级选择评分标准、思考模式的参数映射、V4-Pro和V4-Flash的成本计算示例、缓存策略、JSON模式的注意事项以及一种在发布周节流中仍能生存的错误处理模式。
2026年4月DeepSeek API的实际含义

DeepSeek API是一个无状态的HTTP服务,它接受在OpenAI兼容的Chat Completions请求。 POST /chat/completions 与基本 URL 相抗衡 https://api.deepseek.com。截至 2026年4月24日的 V4 预览公告DeepSeek-V4-Pro拥有1.6T总参数/49B活跃参数,性能可与顶级闭源模型相媲美,而DeepSeek-V4-Flash拥有284B总参数/13B活跃参数,作为快速、高效且经济的选项。两者均作为MIT许可证下的开放权重专家混合模型发布,默认为1,000,000个token的上下文,并且每个响应可以生成高达384,000个输出token。
以下每项最佳实践都受到两个架构事实的影响。首先,API支持OpenAI ChatCompletions和Anthropic API,并且两种模型都支持1M个上下文和双模式(思考/非思考)。其次,API是无状态的——DeepSeek不会在服务器端保留对话历史。chat.deepseek.com的网页聊天会保留您的会话;API不会。您需要重新发送完整的,它今天有效,并将继续工作几个月。deepseek-chat和deepseek-reasoner将在2026年7月24日15:59(UTC时间)后完全退役且不可访问,目前路由到deepseek-v4-flash的非思考/思考模式。迁移只需一行更改:保持base_url,只需更新模型为deepseek-v4-pro或deepseek-v4-flash。没有理由让它留到退役周。切换功能标志,运行一天,删除旧ID。 messages 每次调用都包含数组。
旧版ID和迁移窗口
如果您的代码库仍然引用 deepseek-chat or deepseek-reasonerdeepseek-chat和deepseek-reasoner将在2026年7月24日15:59(UTC时间)后完全退役且不可访问,目前路由到deepseek-v4-flash非思考/思考模式。迁移只需一行更改:保持base_url,只需更新模型为deepseek-v4-pro或deepseek-v4-flash。没有理由让它留到退役周。切换功能标志,运行一天,删除旧ID。 DeepSeek OpenAI SDK compatibility 笔记涵盖了确切的导入路径。
快速入门:2026年你应该进行的调用
下面是我现在用作模板的最小Python代码片段。它针对 deepseek-v4-flash — 对于聊天、分类、摘要以及大多数代理工具调用而言,这是正确的默认设置,并且明确禁用了通过 extra_body={"thinking": {"type": "disabled"}} 由于成本原因(V4默认启用思考功能)。
from openai import OpenAI

client = OpenAI(
    api_key="sk-...",                 # from the DeepSeek console
    base_url="https://api.deepseek.com",
)

resp = client.chat.completions.create(
    model="deepseek-v4-flash",
    messages=[
        {"role": "system", "content": "You are a concise technical assistant."},
        {"role": "user", "content": "Explain context caching in two sentences."},
    ],
    temperature=1.3,                   # DeepSeek's recommended chat default
    max_tokens=512,
    stream=False,
    extra_body={"thinking": {"type": "disabled"}},  # V4 enables thinking by default; explicit disable keeps cost low
)
print(resp.choices[0].message.content)
对同一对象的调用在curl中看起来是这样的;在没有SDK的情况下,这对于从CI进行烟测试很有用: POST /chat/completions 要进行身份验证、计费设置和第一次调用的引导教程,请参阅我们的
curl https://api.deepseek.com/chat/completions
  -H "Authorization: Bearer $DEEPSEEK_API_KEY"
  -H "Content-Type: application/json"
  -d '{
    "model": "deepseek-v4-flash",
    "messages": [{"role": "user", "content": "ping"}],
    "max_tokens": 32
  }'
教程以及如何 DeepSeek API getting started 获取DeepSeek API密钥 维度.
选择正确的层级——V4-Flash或V4-Pro
对于DeepSeek API生产部署来说,最重要的单一决策是选择哪个层级。V4-Pro在输出上的成本大约高出一个数量级,因此默认应该选择Flash,而Pro则保留用于那些经验上能从中受益的任务。
| 总计/活跃参数 | deepseek-v4-flash | deepseek-v4-pro |
|---|---|---|
| Total / active params | 284B / 13B | 1.6T / 49B |
| Context window | 1,000,000 tokens | 1,000,000 tokens |
| Max output | 384,000 tokens | 384,000 tokens |
| 输入,缓存命中($/1M) | $0.0028 | $0.003625(促销价,列表价 $0.0145) |
| 输入,缓存未命中($/1M) | $0.14 | $0.435(促销价,列表价 $1.74) |
| 输出($/1M) | $0.28 | $0.87(促销价,列表价 $3.48) |
| Best for | 聊天,分类,摘要,RAG,大多数工具调用 | 边界编码,长期目标代理,严格推理 |
以下是费率 DeepSeek官方定价页面 截至2026年4月25日,并由如deepseek-v4-flash等独立追踪器证实,deepseek-v4-flash每1M次缓存命中输入令牌的费用为0.0028美元,每1M次缓存未命中输入令牌的费用为0.14美元,每1M次输出令牌的费用为0.28美元;deepseek-v4-pro在2026年5月31日前的75%促销期间,每1M次缓存命中输入令牌的费用为0.003625美元,每1M次缓存未命中输入令牌的费用为0.435美元,每1M次输出令牌的费用为0.87美元(列表价格为0.0145美元/1美元,1.74美元/1美元,3.48美元)。V3用户可能记得的离峰折扣不再有效——它们于2025年9月5日结束,并且没有为V4重新引入。有关实时计算器,请参阅 DeepSeek pricing calculator.
一个简单的路由规则
- 在每个新功能上开始 V4-Flash.构建评估。
- 如果你的评估显示V4-Flash在某些类别上失败——通常是代理编码、多步骤工具使用或困难数学——请在该子集上重新运行V4-Pro。
- 如果Pro将通过率提高足够多,足以证明在这些调用上大约7倍的输出成本是合理的,那么只将该类别路由到Pro。其他所有内容保持在Flash上。
DeepSeek表示,由于架构改进,这两个模型比DeepSeek V3.2更高效、性能更好,并且在推理基准测试中几乎“缩小了差距”与当前领先模型;V4-Pro在推理努力最大化的情况下,在某些任务上超过了OpenAI的GPT-5.2和Gemini 3.0 Pro,但这些胜利集中在最大努力思考上——而不是大多数聊天流量应该采取的廉价快速路径。
故意使用思考模式,而不是默认模式
在V4中,思考是任一层的请求参数,而不是单独的模型ID。三种设置:
- Non-thinking — V4默认启用思考;传递
extra_body={"thinking": {"type": "disabled"}}用于非思考。最快且最便宜。适合聊天、RAG和结构化提取的正确选项。 - Thinking (high) —
reasoning_effort="high"withextra_body={"thinking": {"type": "enabled"}}. 返回值reasoning_contentalongside the finalcontent. 用于多步推理、规划、复杂数学计算。 - Thinking-max —
reasoning_effort="max"保留用于最困难的代理和推理工作负载。对于Think Max推理模式,将上下文窗口设置为至少384K个token,否则您将获得截断的输出。
一个陷阱:思维模式不支持温度、top_p、存在惩罚或频率惩罚参数;为了兼容性,设置这些参数不会触发错误,但也不会产生任何效果。如果您的代码仔细调整 temperature=0.0 用于代码生成,并且您开启了翻转思维模式时,温度将被静默忽略。请相应地规划。
一个思维模式调用:
resp = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[{"role": "user", "content": "Plan a zero-downtime DB migration."}],
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}},
)
print(resp.choices[0].message.reasoning_content)  # the reasoning content
print(resp.choices[0].message.content)            # the final answer
调整温度以适应任务
DeepSeek发布了具体的温度推荐值——除非您有理由不这样做,否则请匹配它们。
| 任务 | 推荐温度 |
|---|---|
| 代码生成、数学 | 0.0 |
| 数据分析、数据清洗 | 1.0 |
| 通用对话、翻译 | 1.3 |
| 创意写作、诗歌 | 1.5 |
如果您发现自己处于 温度=0.7 在所有方面,您可能正在代码路径上放弃确定性,在写作路径上放弃创造力。更多关于提示侧调优的内容请参考 我们DeepSeek提示工程指南.
缓存:你将买到的最便宜的~98%
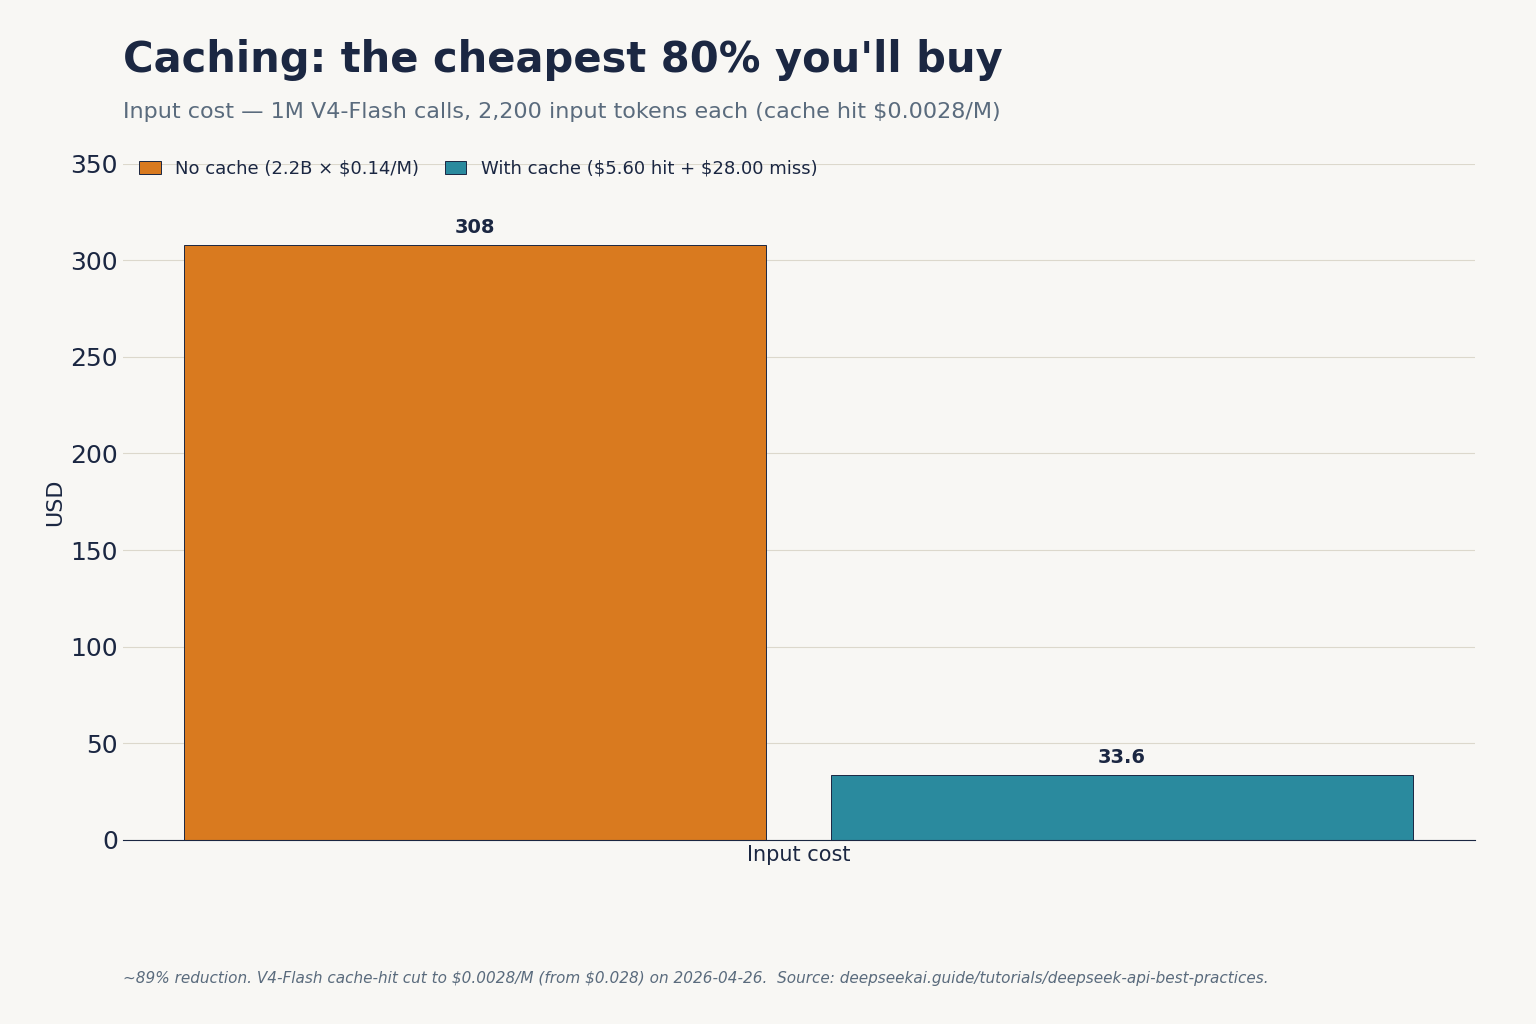
当DeepSeek检测到重复的消息前缀时,上下文缓存会自动应用。缓存命中输入率比V4-Flash上的缓存未命中率便宜约50倍(自2026-04-26缓存命中率下降以来减少了约98%)和V4-Pro促销价时便宜约99%。影响如下:
- 将长篇稳定内容(系统提示、重复出现的检索结果、少样本示例)放在开头 在开头 of
messages. 易变内容(用户的新问题)放在最后。 - 在您的系统提示中避免使用时间戳、请求ID或随机问候语。每一个都是即将发生的缓存未命中。
- 缓存命中并不能免除你为用户的新令牌付费。账单中的未命中行是新对缓存前缀的挑战。
关于实现细节以及前缀匹配器在流和工具调用下的行为,请参阅 我们对DeepSeek上下文缓存的深入分析.
两个层级的实际成本示例
工作负载:每天1,000,000次调用,每次调用包含一个2,000令牌的系统提示,该提示被缓存捕获,一个200令牌的用户消息未被捕获,以及一个300令牌的响应。
V4-Flash(默认推荐)
Cached input :  2,000 × 1,000,000 = 2,000,000,000 tok × $0.0028/M = $5.60
Uncached in  :    200 × 1,000,000 =   200,000,000 tok × $0.14/M   = $28.00
Output       :    300 × 1,000,000 =   300,000,000 tok × $0.28/M   = $84.00
                                                                   -------
Total                                                               $117.60
V4-Pro(前沿层级,相同工作量)
Cached input :  2,000,000,000 tok × $0.003625/M (promo) = $7.25     (list $29.00)
Uncached in  :    200,000,000 tok × $0.435/M    (promo) = $87.00    (list $348.00)
Output       :    300,000,000 tok × $0.87/M     (promo) = $261.00   (list $1,044.00)
                                                            --------
Total                                                       $355.25  (V4-Pro 75% promo through 2026-05-31; list $1,421.00)
相同的流量,在V4-Pro 75%促销期间(至2026-05-31),账单大约增加3倍,列表上大约增加12倍。如果你的评估没有在工作负载上显示出Pro版有意义的优势,那么数学就是答案。 DeepSeek cost estimator 自动对您的token量执行相同的算术操作;the DeepSeek token计数器 帮助您首先进行测量。
无空字符串错误的JSON模式
JSON模式通过设置 response_format={"type": "json_object"}. DeepSeek的文档描述它旨在返回有效的JSON,但不保证。三条规则:
- 在您的提示中包含字面词 “json” 和一个小示例模式。模型使用这两个信号。
- Set
max_tokens足够高,以覆盖最坏情况下的输出。截断的JSON对象是无效的JSON。 - 总是处理空内容的情况。API在负载下可能返回一个空字符串;将其视为暂时性错误并重试一次。
一种防御模式:
resp = client.chat.completions.create(
    model="deepseek-v4-flash",
    messages=[
        {"role": "system",
         "content": "Reply only as JSON matching {"sentiment": "pos|neg|neu"}."},
        {"role": "user", "content": review_text},
    ],
    response_format={"type": "json_object"},
    max_tokens=128,
    temperature=0.0,
)
raw = resp.choices[0].message.content or ""
try:
    parsed = json.loads(raw)
except json.JSONDecodeError:
    parsed = retry_or_fallback()
完整的请求/响应形状和边缘情况被编目在 DeepSeek JSON模式参考.
流式传输和工具调用
Set stream=True 以启用思考模式,接收服务器发送的事件块。 reasoning_content 与最终流并行 content ——在单独的UI界面上渲染它们,否则你会让最终用户感到困惑。有关包括背压处理在内的实现模式,请参阅我们的 DeepSeek API streaming guide.
工具调用使用与OpenAI兼容的 tools 数组。它在思维和非思维模式下都有效。DeepSeek-V4与Claude Code、OpenClaw和OpenCode等领先的AI代理集成,这是OpenAI和Anthropic兼容界面的直接后果——你的现有工具定义可以无缝迁移。 函数调用参考 涵盖了确切的JSON模式要求。
FIM和聊天前缀完成(Beta)
两者都很有用——FIM(填空中间)适用于代码编辑器,Chat Prefix Completion(聊天前缀完成)适用于需要模型扩展部分助手消息的续行式提示。FIM仅用于思考,不要传递 reasoning_effort 在FIM调用中。
能度过启动周的错误处理
将API视为最终可靠,而不是始终可靠。错误包形似OpenAI,因此现有的重试中间件可以工作。
| 状态 | Meaning | Action |
|---|---|---|
| 400 | 错误请求(格式错误,上下文过大) | 不要重试。记录并修复。 |
| 401 | 无效或已撤销的API密钥 | 报告给运维人员;不要重试。 |
| 402 | Insufficient balance | 在线页面;停止流量。 |
| 429 | 速率限制 | 带抖动的指数退避。 |
| 500 / 503 | 服务器端/容量 | 重试最多3次,然后回退。 |
我推荐的两个操作习惯:
- 幂等性。 散列
(模型、消息、温度、种子)并缓存成功的响应约60秒。减少重试客户端调用中的重复支出。 - 层级回退。 如果V4-Pro返回503错误,请使用相同的正文在V4-Flash上重试请求。大多数流量在Flash上运行良好;降级模式优于中断。
完整的状态码映射在 我们DeepSeek API错误代码参考中,速率限制的具体信息在 DeepSeek API rate limits.
可观察性和安全清单

- Log
usage.prompt_tokens,usage.completion_tokens,以及每个响应的缓存/未缓存分割。没有这些,您无法调试账单。 - 将API密钥存储在您的密钥管理器中,而不是在
.env错误提交的文件。每季度旋转一次。 - 考虑数据驻留:请求发送到受中国法律约束的DeepSeek运营的基础设施。对于受监管的工作负载,评估自托管开源权重——请参阅我们关于通过运行DeepSeek的笔记。 DeepSeek Docker deployment.
- 固定
model字符串;不要从用户输入中进行插值。 - 在您的应用层设置每个租户的令牌预算。提供方的限制较为粗略。
关于更广泛的生态系统以及API的适用位置,请参阅 DeepSeek API docs and guides hub.
DeepSeek AI Guide is an independent resource and is not affiliated with DeepSeek or its parent company. Model IDs, pricing and API behaviour change; check the official DeepSeek documentation and pricing page before committing to a production decision.
Frequently asked questions
我如何在不破坏我的应用的情况下从DeepSeek Chat迁移到V4?
修改一行: model="deepseek-chat" 变为 model="deepseek-v4-flash"基础URL、身份验证和请求形状保持不变。旧ID今天路由到V4-Flash,并于2026年7月24日15:59 UTC退役。运行一个功能标志一天以确认延迟和质量,然后删除旧ID。我们的 DeepSeek API documentation 页面包含迁移清单。
检测 DeepSeek API 最便宜的方法是什么?
Use deepseek-v4-flash 在非思考模式下使用简短提示。每百万个缓存未命中输入令牌0.14美元,每百万个输出令牌0.28美元(缓存命中降至0.0028美元——大约减少了98%),一千个500令牌的测试调用只需几分钱,而不是美元。在开发时避免使用思考模式——它会增加输出令牌的数量。在运行之前先估算花费。 DeepSeek pricing calculator.
DeepSeek API 是否会记住之前的消息?
无。API是无状态的——DeepSeek不会在请求之间保留对话状态。您的客户端必须在每次调用时重新发送完整的数组,以维持多轮对话。chat.deepseek.com的网页聊天行为不同,因为会话存储存在于消费者端面,而不是API中。通常情况下。 messages 如果您更喜欢该SDK,DeepSeek也公开了一个与Anthropic兼容的界面,针对相同的基URL。 DeepSeek browser vs app 指南涵盖了消费者端。
我可以使用 OpenAI Python SDK 与 DeepSeek 一起使用吗?
是的。安装 openai 包裹,实例化 OpenAI(base_url="https://api.deepseek.com", api_key="sk-..."),并调用 client.chat.completions.create(...) JSON模式旨在返回有效的JSON,但不保证。在负载下或当模型未能满足约束时,可能会出现空内容。三个修复方法:在提示中包含单词“json”以及一个示例模式,设置足够高以避免截断,并将调用包裹在一个单次重试中,如果失败则回退到确定性解析。 DeepSeek OpenAI SDK compatibility 页面列出了行为相同和少数不同的参数。
为什么我的 JSON 模式调用有时会返回一个空字符串?
全模式在我们的 max_tokens 代码库中。 DeepSeek JSON模式 参考。
来源s & Methodology
Primary sources
- OfficialDeepSeek API documentationEndpoints, request/response shape, model IDsLast checked: April 30, 2026
- PricingDeepSeek API pricing pagePer-1M-token rates, billing units, cache-hit pricingLast checked: April 30, 2026
- OfficialDeepSeek V4 预览公告(2026年4月24日)V4-Pro和V4-Flash的发布规格和参数数量Last checked: April 30, 2026
- PricingDeepSeek官方定价页面V4-Flash和V4-Pro每百万令牌的费率Last checked: April 30, 2026
Technical references
- 技术报告DeepSeek-V3技术报告(arXiv:2412.19437)V3架构和训练方法Last checked: April 30, 2026
Methodology
价格数据已与官方DeepSeek定价页面核对,并使用样本令牌使用场景进行标准化,估算每月成本。实际成本可能因缓存、输入/输出比率、区域可用性和提供商更新而有所不同。
Data confidence
高——数据直接与审查日期的官方定价页面核对。
Editorial note
DeepSeek偶尔会推出促销折扣,这些折扣并不总是反映在首页标题中。本站上的定价数据集每月自动刷新;本文反映了上述日期所示的数据集。