
如果您在深度搜索与OpenAI O1之间进行选择,针对以推理为主的工作负载——如代理编码、多步数学、长文档分析——过去一年中比较结果发生了显著变化。OpenAI的O1,该模型在2024年末定义了“先思考再回答”的类别,现在已成为OpenAI阵容中最昂贵的推理模型,并被O3和GPT-5系列所超越。与此同时,DeepSeek于2026年4月24日发布了V4版本,Pro和Flash两个等级都配备了1000万个token的上下文窗口和推理努力控制,这些功能都集成在一个模型中。
本文为您提供了结论,背后的数据,一个实际成本示例,以及关于何时每个模型仍然是正确选择的明确建议。
结论:DeepSeek V4在价格和平衡性上胜出;o1仅凭惯性胜出

对于2026年4月的全新构建, DeepSeek V4是更好的默认选择 对于推理工作负载——尤其是编码代理、长上下文分析和任何输出token消耗重要的管道。 DeepSeek V4-Pro 帖子 在SWE-Bench验证中达到80.6% 在列表价格为每1000万个输出token 3.48美元(目前2026年5月31日前的75%促销期间为0.87美元/M)的情况下, o1列出了每百万个token输入15美元和输出60美元 ——在V4-Pro促销期间,输出成本大约便宜了69倍(在列表价格为17倍),而对于OpenAI自己定位为过时模型的DeepSeek来说。
o1仍然是正确的选择 在狭窄情况下:依赖o1特定推理行为的现有生产代码、已涵盖OpenAI的企业采购合同,或不愿接受DeepSeek API在中国服务器上处理数据的团队。对于其他人,迁移的数学计算结果强烈倾向于V4。
一目了然比较
| 功能 | DeepSeek V4-Pro | DeepSeek V4-Flash | OpenAI o1 |
|---|---|---|---|
| 发布 | 2026-04-24 | 2026-04-24 | 2024-12(完整发布) |
| 架构 | MoE,总计1.6T / 活跃49B | MoE,总参数量 284B / 激活参数量 13B | 稠密(未公开) |
| 上下文窗口 | 100,000,000 个标记 | 100,000,000 个标记 | 200,000 个标记 |
| 最大输出 | 384,000 个标记 | 384,000 个标记 | ~100,000 个标记 |
| Input (cache miss) | $0.435 / 1M 促销至 2026-05-31(列表价 $1.74);$0.003625 / 1M 促销缓存命中(列表价 $0.0145) | $0.14 / 1M(缓存未命中);$0.0028 / 1M 缓存命中 | $15.00 / 1M |
| Output | $0.87 / 1M 促销至 2026-05-31(列表价 $3.48) | $0.28 / 1M | $60.00 / 1M |
| 推理跟踪已暴露 | 是()reasoning_content) |
是()reasoning_content) |
仅摘要 |
| 开放权重 | 是()MIT) | 是()MIT) | No |
| Best for | 前沿编码,代理 | 高量推理 | 现有的o1管道 |
DeepSeek V4的价格以DeepSeek定价页面2026年4月的数据为准。o1的价格来自OpenAI定价页面和第三方追踪器,也是2026年4月的数据。在做出承诺前请务必核实。
两个模型实际工作原理
DeepSeek V4:一个模型,三种推理模式
V4以两个MIT许可下的开放权重专家混合模型的形式发布。 DeepSeek自家的模型卡 将V4-Pro描述为1.6万亿参数,每个token激活49B,V4-Flash为284B,激活13B,两者都支持一百万token的上下文。推理通过请求参数控制,而不是单独的模型ID:
- Non-thinking — 通过
extra_body={"thinking": {"type": "disabled"}}; 无逐步推理;最便宜且最快。(V4默认启用思考功能。) - Thinking (high) —
reasoning_effort="high"与extra_body={"thinking": {"type": "enabled"}}. - Thinking-max —
reasoning_effort="max"; 需要至少384K个token的上下文窗口以避免截断。
当启用思考功能时,API返回 reasoning_content alongside the final content。您可以读取这两个字段并决定要记录什么、向用户展示什么,或反馈给下游代理。
OpenAI o1:不透明的思考,高端定价
o1是OpenAI的第一个推理模型,现在是OpenAI阵容中最昂贵的模型,每1M token输入15美元,输出60美元。o系列在产生可见输出之前使用内部“思考token”,并且存在成本陷阱(每 OpenAI的推理模型文档)的原因是那些token按输出计费,但仅由 max_completion_tokens限制。一个看似简单的响应可能会悄无声息地消耗5-10倍的可见token数量。OpenAI不会通过API返回完整的推理链——您最多只能得到一个摘要。
OpenAI 本身已经有效地将 o1 停用,转而使用 o3(2 输入/8 输出)进行新构建。如果在 2026 年的架构文档中看到“OpenAI o1”,今天的相关比较通常是 V4 与 o 系列整体相比,而不是 V4 与 o1 的具体比较。
面对面:编码
编码是推理模型证明自身价值的地方,也是 V4-Pro 发挥最大作用的地方。独立审查员报告称,V4-Pro 在 SWE-Bench Verified 上达到 80.6%,仅比 Claude Opus 4.6 低 0.2 分,在 Terminal-Bench 2.0(67.9% 对 65.4%)和 LiveCodeBench(93.5% 对 88.8%)上领先 Claude。在 VentureBeat 对更广泛领域的解读中,V4 的成本大约是 GPT-5.5 和 Opus 4.7 的六分之一,同时在大多数代理基准测试中保持竞争力。
OpenAI 没有发布与 V4-Pro 评估工具直接可比的 o1 的 SWE-Bench Verified 数据——大多数当前的 SWE-Bench 排行榜条目是针对 o3、GPT-5 变体或 Claude。如果你的编码流程目前运行在 o1 上,升级路径更真实地是一个在 o3 和 V4-Pro 之间的选择,而不是留在 o1 上。对于专门的编码工作流程, DeepSeek 编码工具 详细介绍了提示模式和服务代理循环。
头对头比较:推理和数学
这是最具细微差别的类别。o1 的最初成名之处是多步骤推理,在最具挑战性的问题基准(AIME、GPQA Diamond)上,o1 仍然在非思考模式下击败了 DeepSeek V4-Flash。启用思考功能后,V4-Pro 缩小了大部分差距,并在几个代理风格评估中击败它。
有两点需要注意:
- DeepSeek 的 V4 发布公告明确指出,V4-Pro 在 HMMT 2026 上的表现落后于 Claude(96.2%)和 GPT-5.4(97.7%),其自身为 95.2%——因此对于最苛刻的竞赛数学问题,最好的封闭模型仍然保持微小的领先优势。
- HLE(人类最后的考试)将 V4-Pro 的得分定为 37.7%,而 Claude 为 40.0%,GPT-5.4 为 39.8%——在广泛的专家推理上存在有意义的差距。
如果您真正需要最深入的推理能力,且价格不是限制因素,那么OpenAI的思考模型仍然具有竞争力。如果您的推理是“复杂的商业逻辑”而不是“研究生水平的物理学”,那么在思考最大模式下的V4只需一小部分成本就能处理。
头对头比较:上下文和长文档
这是一场一边倒的战斗。V4在两个级别上默认都携带了1,000,000个token的上下文窗口,输出可达384,000个token。o1的上下文为200K,输出限制在大约100K。对于多文档研究、仓库规模的代码审查或长时间运行的代理跟踪,V4有大约5倍的空间。
架构也高效地支持了这一点:DeepSeek的V4-Pro在1M-token上下文中,与V3.2相比,大约需要27%的单token推理FLOPs和10%的KV缓存,根据V4模型卡上的数据。使用o1进行长上下文推理会很快变得昂贵——这既是因为每个token的速率,也是因为推理token会随着输入大小的增加而增加。
头对头比较:定价
Stack the rates side by side and the gap is hard to argue 与:
| 模型 | Input (cache miss) | 缓存输入 | Output |
|---|---|---|---|
| DeepSeek V4-Flash | $0.14 | $0.0028 | $0.28 |
| DeepSeek V4-Pro | $0.435 促销价 / $1.74 列表价 | $0.0145 | $0.87 促销价 / $3.48 列表价 |
| OpenAI o1 | $15.00 | $7.50(50% 缓存) | $60.00 |
输出速率是推理工作负载的关键指标,因为思考模型会输出大量token。V4-Pro在2026-05-31之前的75%促销期间,输出成本比o1便宜约69倍(在列表价格下便宜17倍);V4-Flash便宜约214倍。参见 DeepSeek API 定价 查看完整费率表。
成本示例:每天1,000个推理任务
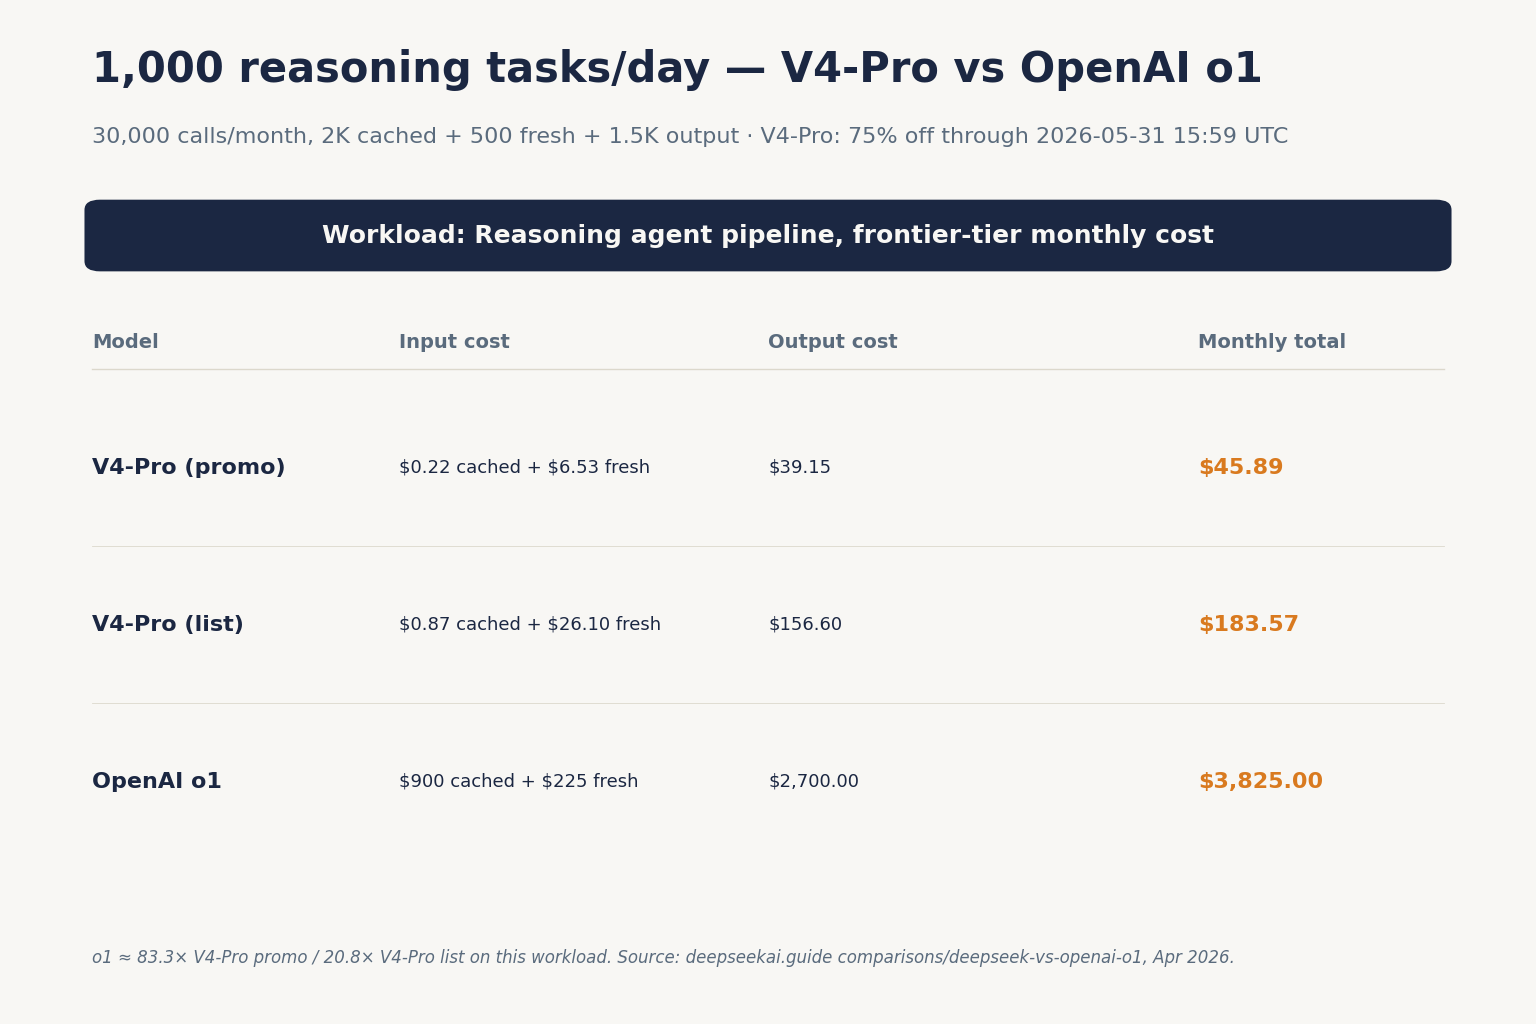
想象一个每天运行1,000个任务、每月运行30,000个任务的编码代理管道。每个任务使用一个2,000个token的系统提示(跨调用缓存),一个500个token的用户消息(每个调用不缓存),并生成一个1,500个token的推理跟踪和答案。我们正在计算 DeepSeek V4-Pro不是 V4 Flash,因为这是一个前沿级别的负载。
# Promo rates (current through 2026-05-31)
缓存输入    : 60,000,000 × $0.003625/M = $0.22
Uncached input  : 15,000,000 × $0.435/M    = $6.53
Output          : 45,000,000 × $0.87/M     = $39.15
                                            -------
Monthly total (promo)                       $45.90

# List rates (after 2026-05-31)
缓存输入 (list)   : 60,000,000 × $0.0145/M = $0.87
Uncached input (list) : 15,000,000 × $1.74/M   = $26.10  # promo $0.435/M = $6.53
Output (list)         : 45,000,000 × $3.48/M   = $156.60 # promo $0.87/M = $39.15
                                          -------
Monthly total (list)                      $183.57
在o1上的相同工作量(除非您选择50%的缓存输入率,否则系统提示没有自动前缀缓存):
缓存输入    : 60,000,000 tokens × $7.50/M  = $450.00
Uncached input  : 15,000,000 tokens × $15.00/M = $225.00
Output          : 45,000,000 tokens × $60.00/M = $2,700.00
                                                ---------
Monthly total                                    $3,375.00
在促销价格下,相对于o1大约贵73倍;促销结束后,在目录价格下,大约贵18倍。在任务允许的情况下迁移到V4-Flash,差距会扩大到大约100倍。您可以在[URL]中运行自己的数字。 DeepSeek 定价计算器.
头对头比较:隐私和生态系统
这就是o1仍然有可辩护的理由的地方。DeepSeek的API在中国服务器上处理数据;对话可能受到中国法律和执法程序下的访问限制。OpenAI根据您的计划在美国、欧盟或指定地区处理数据。对于受监管的行业——如医疗保健、法律、金融,以及跨境数据限制——这比价格差距更重要。
DeepSeek 的抵消优势在于 V4 的权重是 MIT 许可的 MIT 许可 可从Hugging Face下载。如果数据驻留是不可协商的,您可以在自己的基础设施上运行V4-Flash。o1是封闭的;没有自托管版本。有关此权衡的更多信息,请参阅[URL]。 DeepSeek 隐私.
与API对话:一个最小示例
DeepSeek API 与 OpenAI 兼容。聊天请求击中 POST /chat/completions, the OpenAI-compatible endpoint, 与 the same wire format as api.openai.com. 唯一的变化是 base_url, api_key,以及 model 字段。这里有一个使用 V4-Pro 在思考模式下的最小化 Python 示例:
from openai import OpenAI

client = OpenAI(
    base_url="https://api.deepseek.com",
    api_key="YOUR_KEY",
)

resp = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {"role": "user", "content": "Audit this SQL query for n+1 issues..."},
    ],
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}},
    max_tokens=8000,
)

print(resp.choices[0].message.reasoning_content)  # the trace
print(resp.choices[0].message.content)            # the answer
API是无状态的——客户端必须在每个请求中重新发送完整的对话历史。chat.deepseek.com上的网页聊天会为用户保留会话历史;API不会。DeepSeek还通过相同的基URL暴露了与Anthropic兼容的界面,因此现有的Claude SDK代码可以最小化更改地切换提供商。
如果您正在维护较旧的集成,遗留的 deepseek-chat and deepseek-reasoner 模型 ID 仍然有效,并且目前路由到 deepseek-v4-flash。所有遗留 ID 将于 2026-07-24 15:59 UTC退役;迁移是一个单行 model= 交换,而 base_url 保持不变。逐步设置步骤在 DeepSeek API getting started guide.
何时选择哪个

选择DeepSeek V4的情况
- 您对成本敏感,且工作负载生成大量输出令牌。
- 您需要一个1M令牌的上下文窗口——长文档、代码库、多文件差异。
- 您需要开放权重以进行自托管或可审计性。
- 您希望将推理跟踪作为结构化字段,而不是摘要。
- 您的数据驻留政策允许在中国进行处理,或者您自行托管。
选择OpenAI o1(或者更诚实地说,o3 / GPT-5思维)的情况
- 您已有现有的o1部署,您希望不重新验证。
- You’re inside an enterprise procurement contract 与 OpenAI already.
- 您的工作负载需要在HLE风格基准(最新封闭模型——不是特定于o1——目前领先)上获得最高的已发布推理分数。
- 跨境数据合规规则排除了中国基础设施,您无法自行托管。
值得考虑的替代方案
这不是一个二进制文件。几个模型在价格/质量曲线上位于V4和o1之间:
- DeepSeek R1 与 OpenAI o1 对比 ——原始的2025年面对面比较,如果您正在维护R1部署,仍然有用。
- DeepSeek vs Claude ——Claude Opus 4.6在编码基准测试中是V4-Pro性能最接近的同类产品。
- DeepSeek vs ChatGPT ——如果您是为团队而不是后端选择,更广泛的app-vs-API比较。
查看更多推理特定选项,请浏览 DeepSeek推理替代方案 或更广泛的 AI comparison hub.
DeepSeek AI指南是一个独立资源,与DeepSeek及其母公司无关。模型ID、定价和API行为会发生变化;在做出生产决策之前,请检查DeepSeek的官方文档和定价页面。
DeepSeek是否比OpenAI o1更适合推理?
对于2026年的大多数推理工作负载,DeepSeek V4-Pro在思考模式下,以大约1/17的输出成本与o1在代理和编码基准上相当或更胜一筹。在难度最大的竞赛数学和专家知识基准(HMMT、HLE)中,最新的封闭模型仍然领先,但o1与当前前沿——OpenAI本身定位的o3——已不再具有竞争力。参见 DeepSeek V4-Pro 页面以获取完整的基准详情。
DeepSeek V4比OpenAI o1便宜多少?
DeepSeek V4-Pro目前的价格为0.435美元输入缺失/0.87美元输出,直至2026年5月31日的75%促销期间(列表价格为1.74美元/3.48美元),与o1的15美元输入和60美元输出相比——在促销期间,输入成本大约便宜34倍,输出成本便宜69倍(在列表价格上,输入便宜8.6倍,输出便宜17倍)。V4-Flash以每百万个令牌0.14美元/0.28美元的价格进一步拉大差距。通过API响应中的单独字段运行您自己的数字。 DeepSeek 定价计算器 在提交之前。
DeepSeek是否会像o1一样公开其推理轨迹?
DeepSeek在这里比o1做得更深入。当启用思考模式时,V4返回... reasoning_content alongside the final content OpenAI的o系列仅返回推理的摘要,而不是完整的链。这对于审计跟踪、代理编排和调试很重要。V4-Pro和V4-Flash的权重是MIT许可的,并发布在Hugging Face上,所以是的——您可以自行托管。V4-Flash(总参数量284B/活跃参数量13B)是大多数团队的现实选择;V4-Pro的参数量为1.6T,需要严肃的基础设施。V4-Pro和V4-Flash(分别以非思考模式和思考模式)。两者将于2026年7月24日15:59 UTC退役,之后使用这些ID的请求将失败。迁移是一条 DeepSeek API documentation 遍历了两个字段。
我能否在本地运行DeepSeek V4以避免将数据发送到中国?
价格已按每100万个输入和输出令牌与每个供应商在审查日期的官方定价页面进行了标准化。基准分数被视为方向性指标,而不是实际性能的保证。实际比较还考虑了编码、推理、摘要和开发者工作流程场景。 install DeepSeek locally 本教程涵盖了硬件要求和设置。o1没有自托管选项。
2026年7月之后,deepseek-chat和deepseek-reasoner会发生什么?
The legacy deepseek-chat and deepseek-reasoner 模型ID目前路由到... deepseek-v4-flash 迁移是一条命令行操作。 model= 交换;该... base_url 不变。DeepSeek的最新更新... DeepSeek API定价页面 每百万令牌费率,计费单位,缓存命中定价
来源与方法
主要来源
- OfficialDeepSeek API documentationEndpoints, request/response shape, model IDsLast checked: April 30, 2026
- PricingDeepSeek API 定价 pagePer-1M-token rates, billing units, cache-hit pricingLast checked: April 30, 2026
- 模型 cardHugging Face上的DeepSeek每个模型的权重、许可证、使用说明Last checked: April 30, 2026
- PricingAnthropic Claude定价Claude API跨供应商比较费率Last checked: April 30, 2026
- PricingOpenAI API 定价OpenAI API跨供应商比较费率Last checked: April 30, 2026
- 模型 cardHugging Face:DeepSeek-V4-Pro模型卡片V4-Pro / V4-Flash大小、活跃参数、上下文窗口Last checked: April 30, 2026
技术参考
- 技术报告DeepSeek-V3技术报告(arXiv:2412.19437)V3架构和训练方法Last checked: April 30, 2026
- 技术报告DeepSeek-R1论文(arXiv:2501.12948)R1推理方法、蒸馏结果Last checked: April 30, 2026
- 基准测试SWE-Bench验证排行榜软件工程基准测试分数Last checked: April 30, 2026
- 基准测试LiveCodeBench实时编码基准测试分数Last checked: April 30, 2026
上下文来源
- 分析BuildFastWithAI: DeepSeek V4-Pro评测V4-Pro的80.6% SWE-Bench验证引用率Last checked: April 30, 2026
- 分析PE Collective: OpenAI o-series API 定价 trackero1定价(输入15美元/输出60美元)和思考令牌成本陷阱Last checked: April 30, 2026
方法
价格已按每100万个输入和输出令牌与每个供应商在审查日期的官方定价页面进行了标准化。基准分数被视为方向性指标,而不是实际性能的保证。实际比较还考虑了编码、推理、摘要和开发者工作流程场景。
Data confidence
官方定价和功能存在度高;跨厂商基准比较中等;主观工作流程评价低。
Editorial note
市场中的定价和型号系列经常变化。此处评价是根据上述日期校准的,购买决策前应重新检查。